日報 2023.05.22
ゆで太郎知らない気になる。調べてみると関東の蕎麦屋チェーンで大阪は運良く堺筋本町に1店舗だけあった。そもそも蕎麦ってあんまり食わないので蕎麦屋のチェーンって全然知らないわ。
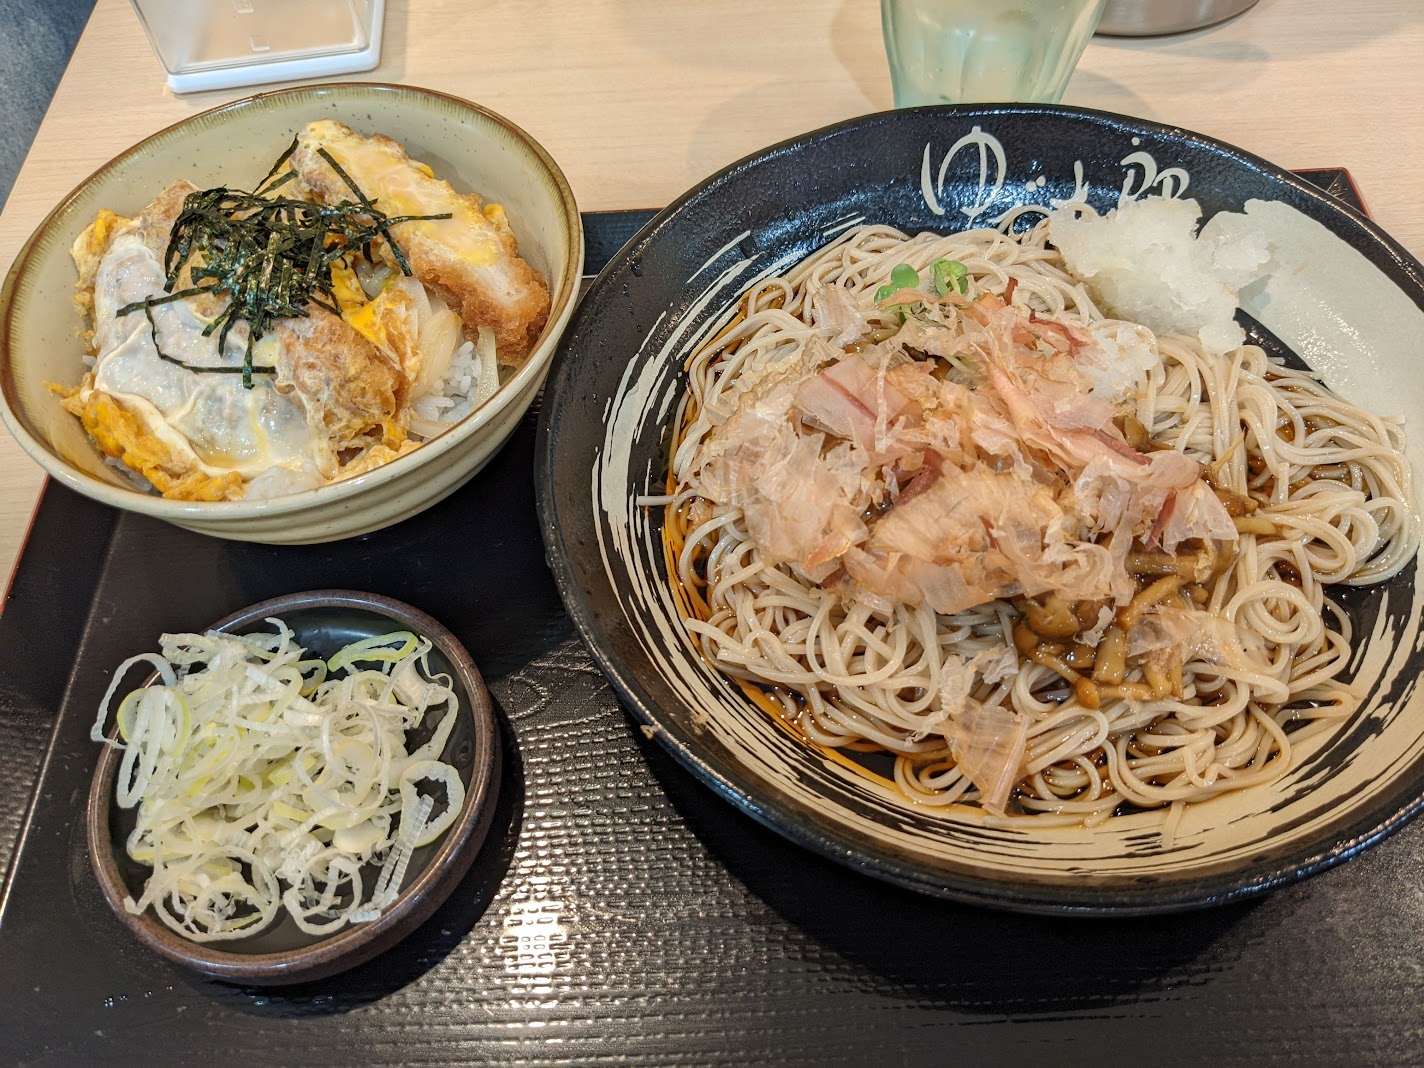
そして機運を高めまくったところでエリート飯。蕎麦は普通。おまけのカツ丼は思ってたより旨かった。通常の蕎麦メニューだとミニカツ丼セットがあって結構量が多くて安い。関東のチェーンだからなのか蕎麦汁は結構甘めに感じた。
VSCodeの拡張機能「Insert Numbers」でいつの間にかデフォルト以外フォーマットで連番入力しようとするとデフォルトで入力した連番の後にそれが追記される不具合が出てて、サーベイすると同じIssueが既に上がってたけどオーナーの妖夢が既にリポジトリを全くメンテしてない模様。
代わりの連番入力系の拡張機能をサーベイすると、最近リポジトリ更新されてる”Insert Seq(Insert Nums)”が有力っぽい。Sublime Text用のプラグインをベースに作ってるらしい。フォーマットの記載方法がInsert Numbersと全然違うので戸惑うけど慣れたらこっちのほうが高性能に見えるので完全移行してみる。
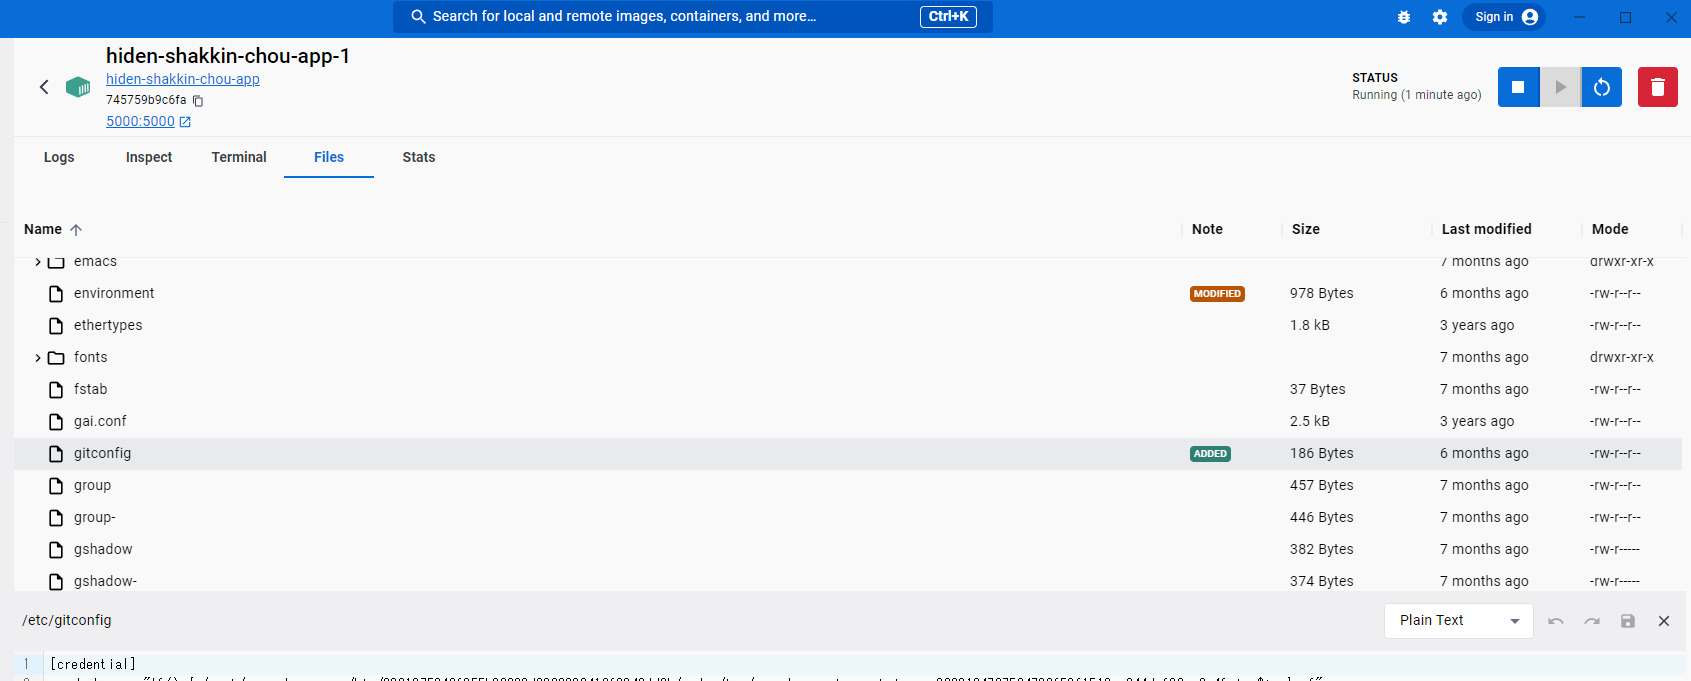
Docker Desktopをアップデートしたらいつのまにかコンテナ内のファイルをエクスプローラーのようにアクセスできるようになってた。めっちゃ便利。そのままテキストファイル編集もできる。
エリート退社で雨被弾。
雨被弾で急いでいたからなのかSwytchのサムスロットルのサム部分が折れてしまった。型番はFT-21XっぽいのでAliで注文しておく。
(なお日本の公道を走行するためスロットルのパーツをつけている”だけ”で接続はしておらず稼働はもとからしません。ただのアクセサリです。)
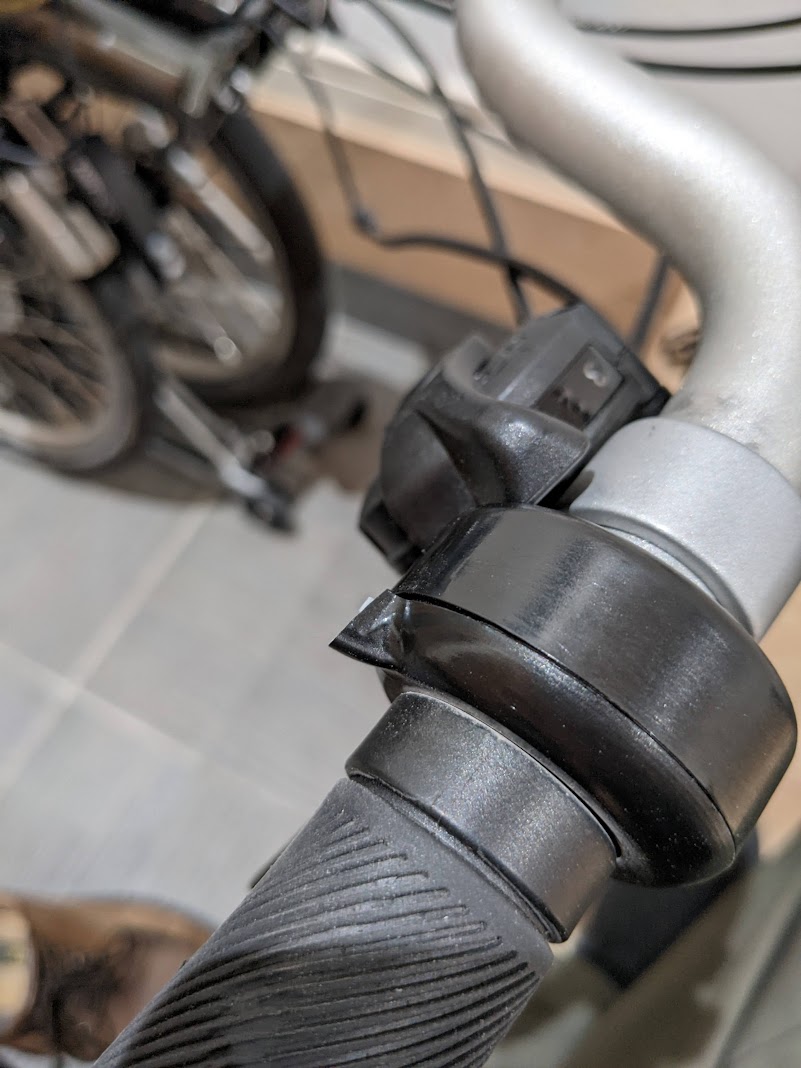
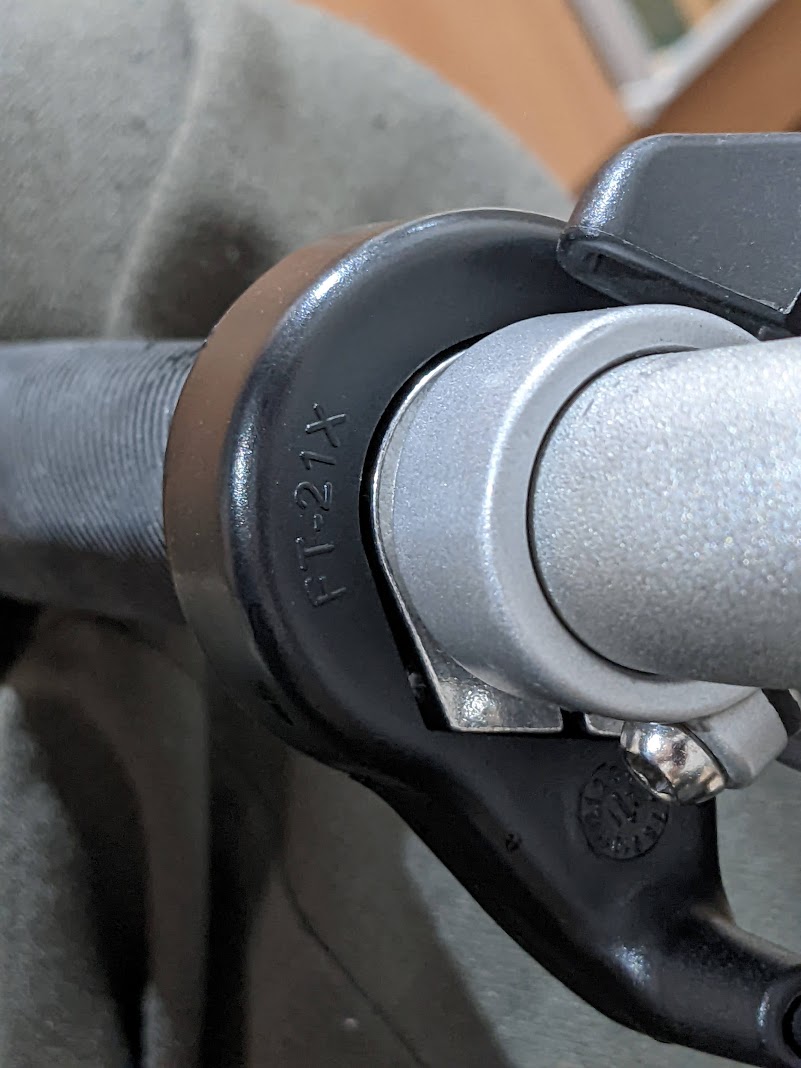
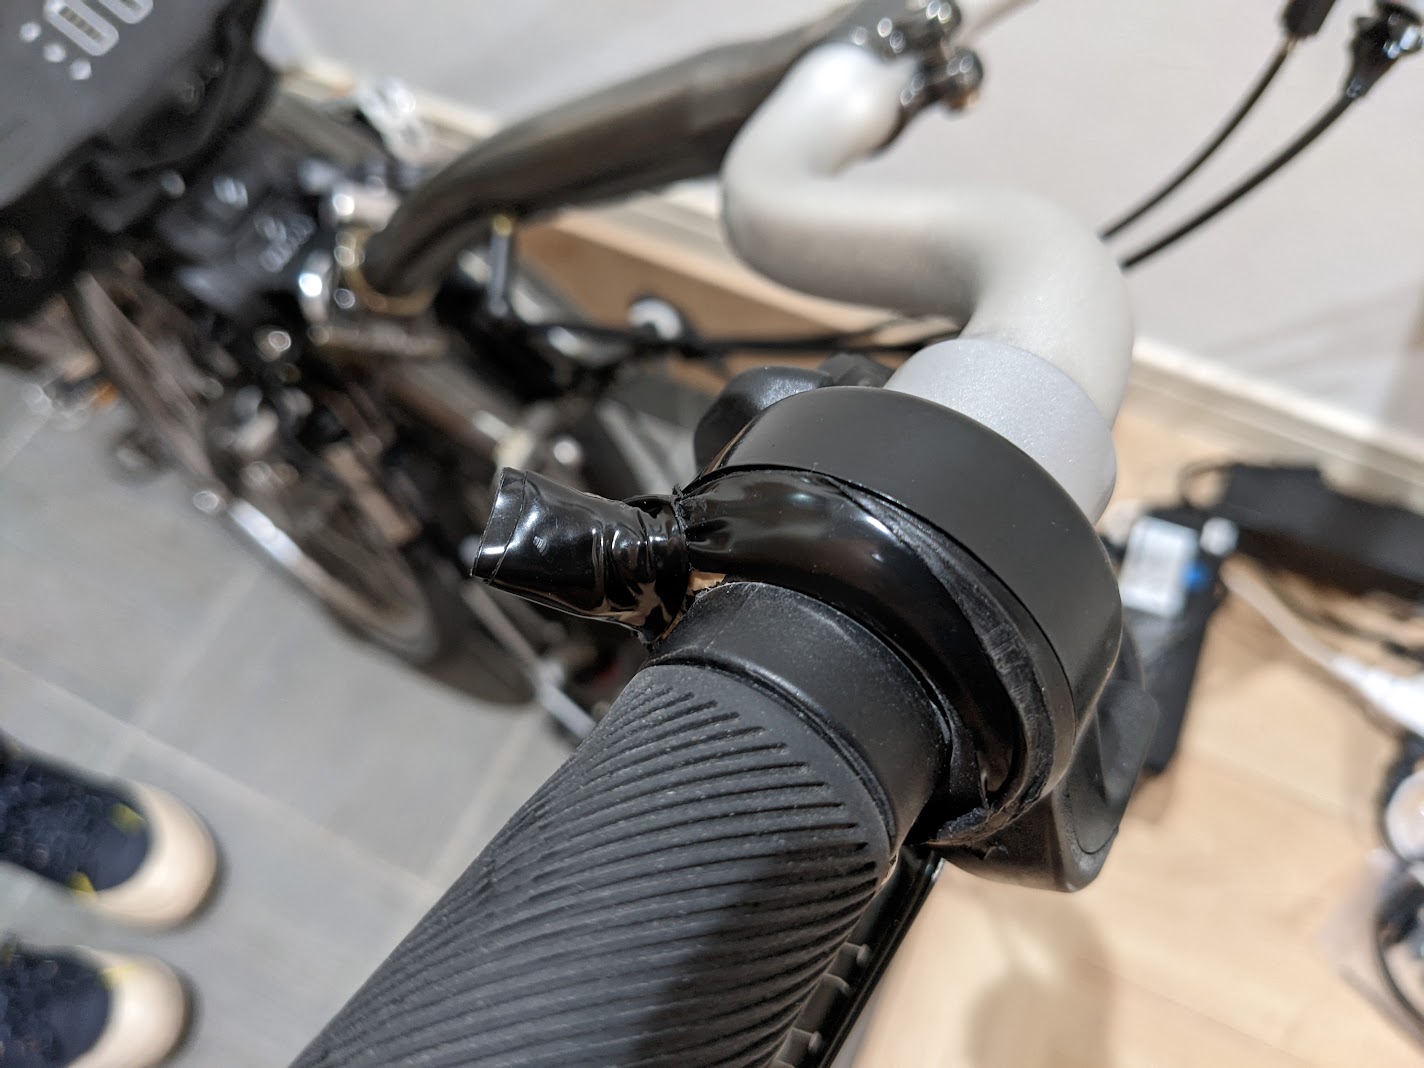
布テープと自己融着テープでしばらくごまかす。
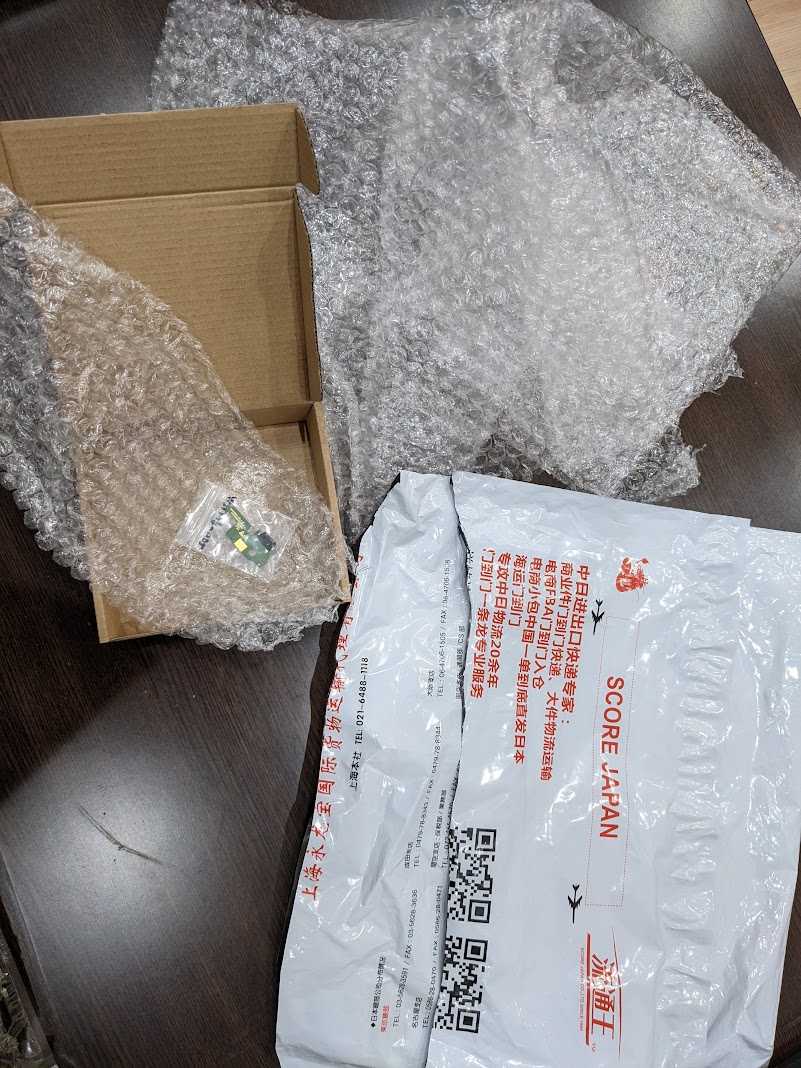
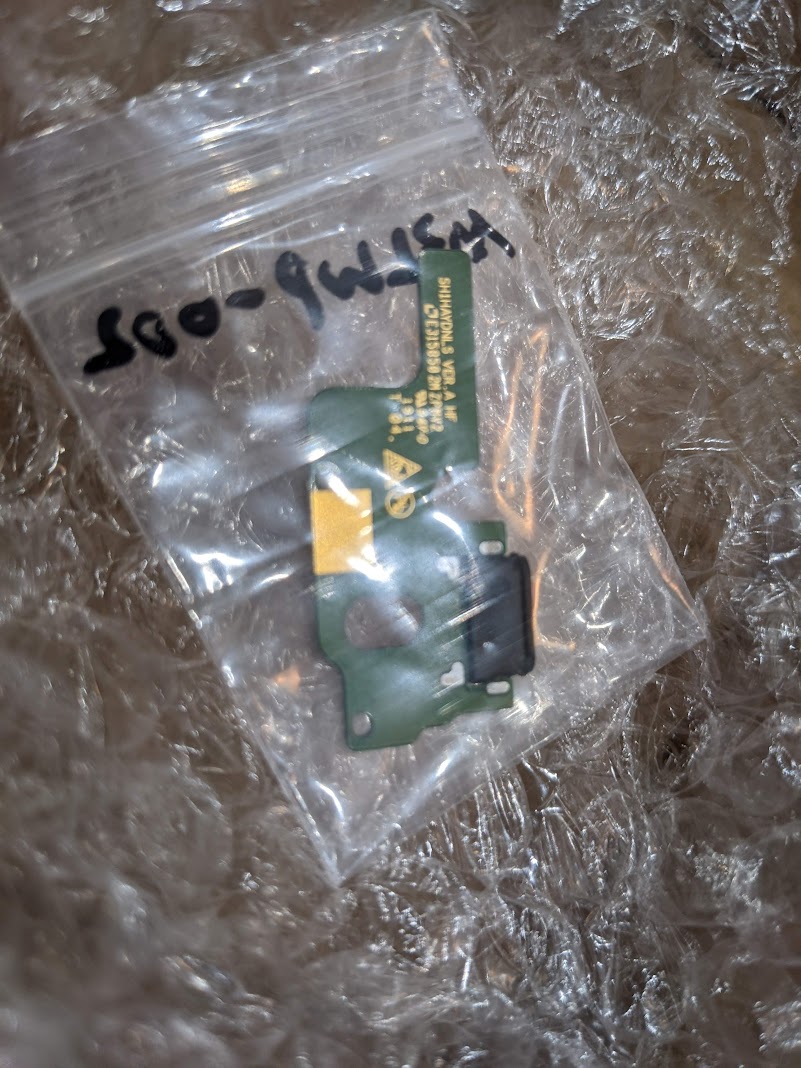
MediaPad M3 lite 10 wp用USB充電ポート基板が超過剰梱包で届いた。たしか送料1,300円(!?)したので過少梱包で良いから1200円くらい安くしてほしい。取り付けは後日やる。
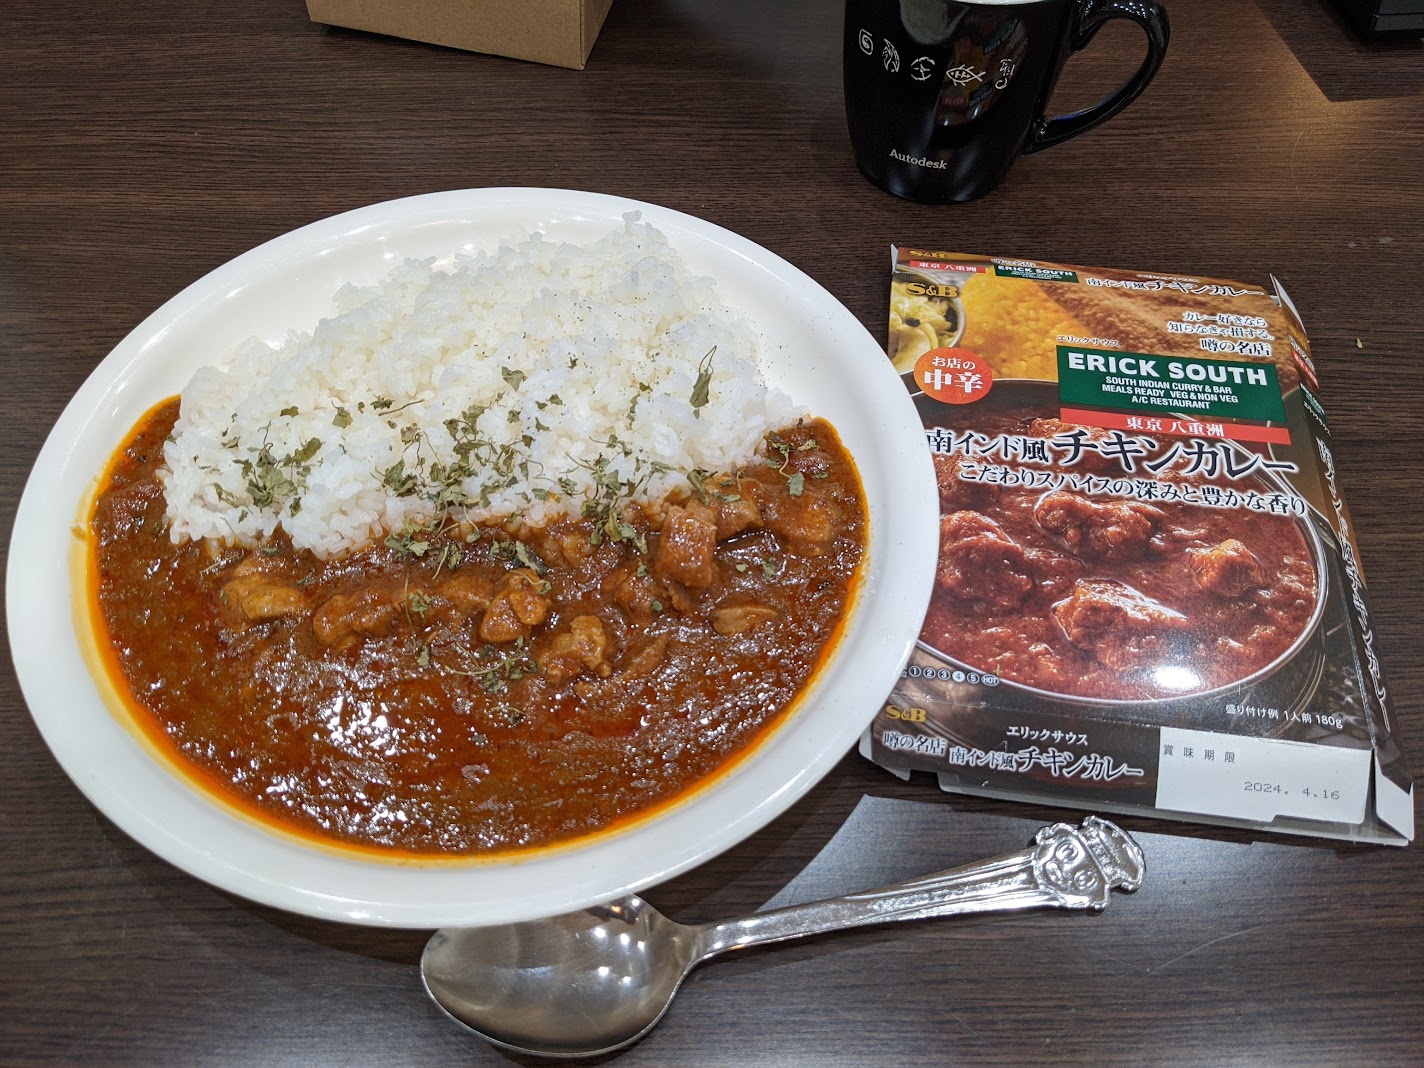
エリート飯。カスリメティは非同梱なのでお間違えないようご注意。#カレーデバッグ
内職にて、PostgreSQLのデータベースに対する日本語での文字列の部分一致検索にだいぶもたつきが出始めて来たので解決策をサーベイ。
pg_biamというモジュールで高速化できるらしい。
文字列データから2-gram(バイグラム)という手法で文字列を分割したデータでインデックスを作成して、インデックス検索を行えるようにして高速化するものらしい。試してみる。
dockerコンテナ内で使う予定でmakeができなかったのでビルド環境を以下コマンドでインストール。
apt install make
apt install build-essential -y --no-install-recommends
apt install postgresql-server-dev-14 (PostgreSQL 14のイメージ使ってるので14)
apt install libicu-devel
無事にビルドできたら手順にしたがってpg_bigmをインストール。
拡張機能が有効になっているかどうか確認するにはpsqlで以下コマンド実行。
SELECT * FROM pg_extension;
そして全文対象の部分一致検索、検索文字列は適当に目についた「ケース」で。レコード数は50万程度。
まずは普通にlikeでシーケンシャル検索。2301.952 ms で結構遅い。
explain analyze select * from items where item_name like '%ケース%' or description_pc like '%ケース%' or description_mobile like '%ケース%';Seq Scan on items (cost=0.00..111992.68 rows=51545 width=1201) (actual time=3.390..2300.359 rows=21433 loops=1)
Filter: ((item_name ~~ '%ケース%'::text) OR (description_pc ~~ '%ケース%'::text) OR (description_mobile ~~ '%ケース%'::text))
Rows Removed by Filter: 477763
Planning Time: 0.432 ms
JIT:
Functions: 2
Options: Inlining false, Optimization false, Expressions true, Deforming true
Timing: Generation 0.445 ms, Inlining 0.000 ms, Optimization 0.259 ms, Emission 2.982 ms, Total 3.686 ms
Execution Time: 2301.952 ms3つのパラメーターに対してインデックス作成。
CREATE INDEX idx_item_name ON items USING gin (idx_item_name gin_bigm_ops);
CREATE INDEX idx_description_pc ON items USING gin (description_pc gin_bigm_ops);
CREATE INDEX idx_description_mobile ON items USING gin (description_mobile gin_bigm_ops);
再実行。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
Bitmap Heap Scan on items (cost=607.40..63199.60 rows=51149 width=1198) (actual time=25.208..1559.203 rows=21433 loops=1) Recheck Cond: ((item_name ~~ '%ケース%'::text) OR (description_pc ~~ '%ケース%'::text) OR (description_mobile ~~ '%ケース%'::text)) Rows Removed by Index Recheck: 5427 Heap Blocks: exact=21189 -> BitmapOr (cost=607.40..607.40 rows=52939 width=0) (actual time=22.812..22.813 rows=0 loops=1) -> Bitmap Index Scan on idx_item_name (cost=0.00..240.43 rows=24057 width=0) (actual time=7.193..7.193 rows=17615 loops=1) Index Cond: (item_name ~~ '%ケース%'::text) -> Bitmap Index Scan on idx_description_pc (cost=0.00..164.31 rows=14441 width=0) (actual time=7.910..7.911 rows=26860 loops=1) Index Cond: (description_pc ~~ '%ケース%'::text) -> Bitmap Index Scan on idx_description_mobile (cost=0.00..164.31 rows=14441 width=0) (actual time=7.705..7.705 rows=26860 loops=1) Index Cond: (description_mobile ~~ '%ケース%'::text) Planning Time: 12.306 ms Execution Time: 1562.179 ms |
思ったより早くならない…。
さらにサーベイするとインデックスにGroongaというものを使うPostgreSQLの拡張機能PGroongaというものがあり、pg_bigmよりも早いらしいので試してみる。docker用のimageが公式で配布されているので楽。
- Groonga – カラムストア機能付き全文検索エンジン
- padrino+PostgreSQLで作ったサイトを高速全文検索対応にする – Qiita
- PostgreSQLの日本語対応全文検索モジュールpg_bigmとPGroongaを検証してみた – CreateField Blog
こっちもインデックスを貼って再検索テスト。
CREATE INDEX idx_item_name ON items USING pgroonga (item_name);
CREATE INDEX idx_description_pc ON items USING pgroonga (description_pc);
CREATE INDEX idx_description_mobile ON items USING pgroonga (description_mobile);
likeの代わりに謎の”@@” コマンド。
explain analyze select * from items where item_name @@ 'ケース' or description_pc @@ 'ケース' or description_mobile @@ 'ケース';
追記 2023.05.23
jsonb型以外の型用の&@~演算子 | PGroonga
@@演算子は非推奨になってて&@~になっていた。
お、結構早い。
Gather  (cost=1003.67..99556.81 rows=4889 width=1177) (actual time=38.742..538.709 rows=21451 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Parallel Bitmap Heap Scan on items  (cost=3.67..98067.91 rows=2037 width=1177) (actual time=12.939..396.521 rows=7150 loops=3)
        Recheck Cond: ((item_name @@ 'ケース'::text) OR (description_pc @@ 'ケース'::text) OR (description_mobile @@ 'ケース'::text))
        Heap Blocks: exact=8663
        ->  BitmapOr  (cost=3.67..3.67 rows=113556 width=0) (actual time=36.589..36.590 rows=0 loops=1)
              ->  Bitmap Index Scan on idx_item_name  (cost=0.00..0.00 rows=28622 width=0) (actual time=10.944..10.944 rows=16621 loops=1)
                    Index Cond: (item_name @@ 'ケース'::text)
              ->  Bitmap Index Scan on idx_description_pc  (cost=0.00..0.00 rows=42467 width=0) (actual time=14.691..14.691 rows=21451 loops=1)
                    Index Cond: (description_pc @@ 'ケース'::text)
              ->  Bitmap Index Scan on idx_description_mobile  (cost=0.00..0.00 rows=42467 width=0) (actual time=10.949..10.949 rows=21451 loops=1)
                    Index Cond: (description_mobile @@ 'ケース'::text)
Planning Time: 4.691 ms
Execution Time: 540.964 ms
ということでPGroonga採用してしばらく様子見。DB経験が年齢に伴っていないので拡張機能初めて使いました。
そういや今日は0800起床の予定がしっかり0930に目覚めてしまいさっそく早起き失敗。(0930でも人間工学的におかしいぐらい早いが)
今日こそてっぺんおやすみチャレンジの予定だったが人生そう旨くは行かず。やはり人の生活習慣を正すには脱出ではなく引退が求められるのだ。
おわい